AI 都会写代码了,为什么 CUDA 的护城河还是这么深?
这两年 AI 写代码的能力涨得飞快,补全、重构、写测试、改 Bug,很多活交给 Agent 跑一晚上就能出结果。于是一个问题自然冒了出来:既然 AI 能把一份 CUDA 代码翻译成 HIP、SYCL、Triton,甚至直接写出新的 GPU kernel,那 NVIDIA 靠 CUDA 建起来的生态壁垒,是不是很快就要被“翻译”掉了?
先说结论:不会那么快。 CUDA 的壁垒从来不在“语法”,而在语法下面那几层:几百个调到极致的库、和硬件一起演进的编译与工具链、NVLink 这种软硬一体的系统设计,以及全世界开发者和代码对它形成的默认依赖。AI coding 能把“写代码”变便宜,但护城河里最贵的部分是“验证、调优、长期维护”,而这些都离不开真实硬件、真实负载和时间。它确实在削弱护城河,只是削的位置和很多人想的不一样。
一、壁垒不在语法,而在下面那几层
很多人对 CUDA 的印象是“一种 C++ 方言”:__global__、<<<grid, block>>>、threadIdx.x。如果只是这一层,那确实没什么护城河,AMD 的 HIPIFY 早就能把它批量改成 HIP,Intel 的 SYCLomatic 官方说法是通常能自动迁移 90%–95% 的 CUDA 代码。
但 CUDA 实际上是一整栋楼:
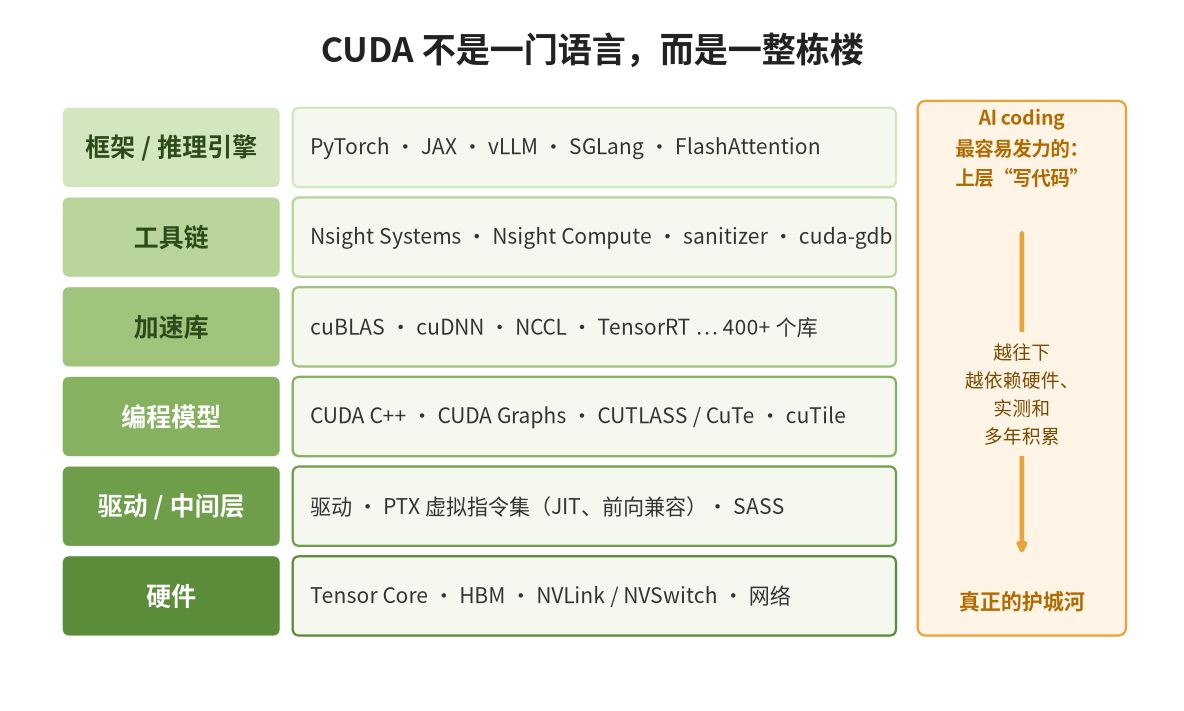
- 最底下是硬件:Tensor Core、HBM,还有 NVLink / NVSwitch。
- 往上是 PTX 和驱动:PTX 是一层虚拟指令集,新显卡可以把旧 PTX 现场 JIT 编译成自己的机器码,所以十几年前写的 CUDA 程序,在新卡上大多还能跑。
- 再往上是 CUDA-X 加速库:cuBLAS、cuDNN、NCCL、TensorRT、cuFFT……NVIDIA 官方的说法是“超过 400 个库”。
- 再往上是工具链和框架:Nsight 系列分析器,PyTorch、JAX、vLLM、SGLang 等框架和推理引擎。
AI coding 最擅长的是这栋楼的“外墙”,也就是把一段代码改写成另一种写法。真正把用户锁住的,是墙里面的钢筋。
二、库与性能长尾:最后 20% 的性能要花 80% 的力气
做深度学习的人很少直接写 CUDA,日常写的是这种代码:
1 | import torch |
一行 x @ x.T 背后是 cuBLAS 为每代架构、每种精度(FP32 / TF32 / BF16 / FP8 / FP4)、每类矩阵形状调好的一堆 kernel,还有运行时的启发式选择。这种库的价值有两个特点:
- 长尾极长。主流形状好优化;难的是成千上万种“不主流”的形状、精度组合、融合模式。Meta 在 KernelEvolve 论文里提到,他们的广告推荐模型要跑 200 多种数据预处理算子,跨 NVIDIA、AMD 和自研 MTIA 三种硬件。每个平台的实现靠专家手调需要 2–8 周,而硬件 12–18 个月就换一代。
- 跟硬件代际强绑定。PTX 虽然保证了“旧代码能跑”,但跑得快要靠针对新架构的专门实现。NVIDIA 的 Blackwell 兼容指南写得很清楚:带
a后缀的架构专用 PTX(比如sm_90a)并不能前向兼容到 Blackwell。FlashAttention-3 是专门针对 Hopper 写的,到了 Blackwell,社区又得为它准备新的实现。
也就是说,每一代新卡,NVIDIA 自己和生态里的高手都要把最热的那批 kernel 重写一遍。挑战者要追的不是一个静态目标,而是一个每年都在往前跑的目标。
三、工具链与调试:出了问题,你能不能看清楚
写 GPU 程序,最痛苦的不是写,而是:
- 为什么结果偶尔差了 1e-3?
- 为什么换个 batch size 就慢了一倍?
- 为什么 8 卡能跑、64 卡就挂?
NVIDIA 在这一块有 Nsight Systems(看时间线)、Nsight Compute(看单个 kernel 的占用率、访存、指令)、compute-sanitizer、cuda-gdb 这一整套工具,十几年下来,文档、论坛帖子、StackOverflow 问答都积累得很厚。
这对 AI coding 恰恰也很关键:AI Agent 优化 kernel,本质上是“写 → 跑 → 看 profiler → 再改”的循环。工具链越成熟,Agent 拿到的反馈越精准。Meta 的 KernelEvolve 就专门接入了 NCU(Nsight Compute)、Triton Proton 等分析器给 Agent 做反馈。也就是说,AI 越会用工具,NVIDIA 成熟的工具链反而越值钱。
四、硬件协同:有些护城河根本不是软件
再往下看,有些壁垒干脆不在代码里。
以 GB200 NVL72 为例:72 块 Blackwell GPU 通过 NVLink Switch 全互联。按 NVIDIA 公布的规格,NVLink 5 每块 GPU 有 1.8 TB/s 的双向带宽,整个 NVL72 域的 GPU 间聚合带宽约 130 TB/s。NCCL 之类的通信库就是围着这种拓扑一起设计、一起调优的。
大模型训练和推理越来越像“系统工程”,瓶颈常常在通信而不在算力。你可以把单个 kernel 翻译过去,但“72 块卡像一块大卡一样协作”这件事,是芯片、互联、交换机、通信库、框架一起设计出来的,没法靠改写代码搬走。
五、网络效应与人才:默认选项的力量
CUDA 2006 年发布,到今天已经二十年。NVIDIA 2025 年的公司介绍里写的是约 590 万开发者,CUDA-X 库和模型累计超过 900 个。
这带来的是典型的网络效应:
- 论文和开源项目默认先支持 CUDA。一个新的注意力变体、新的量化格式出来,第一版几乎一定是 CUDA / Triton-on-NVIDIA 实现。
- 招人默认招 CUDA 背景。会写高性能 CUDA 的人本来就稀缺,他们的经验大量绑定在 NVIDIA 的硬件细节上。
- 云上默认是 NVIDIA。研究者手边能拿到的卡最多,生态就继续向它倾斜。
还有一点经常被忽略:AI coding 自己的训练数据也是 CUDA 最多。 模型见过海量的 CUDA 代码、博客和问答,写 CUDA 往往比写冷门 DSL 更顺手。Meta 的 KernelEvolve 为了让大模型给自研 MTIA 芯片写 kernel,专门维护了一个知识库,把 MTIA 的硬件特性和编程扩展“喂”进上下文。原因很直接:这些东西不在公开训练语料里。从这个角度说,AI coding 短期内甚至在加固 CUDA 的默认地位。
六、AI coding 能做什么、做不到什么
这是最关键的一节。先看几组近一年多的真实数据。
1)“写对”比“写快”容易得多。 斯坦福 2025 年初的 KernelBench(250 道 PyTorch → kernel 的题)发现,当时的前沿模型生成的 kernel,只有不到 20% 的情况能追平 PyTorch 基线。到了 2026 年,模型强了很多,但 Meta 和斯坦福的 KernelBench-Verified 做了两件事:把 PyTorch 基线改成实际常用的 TF32 模式,再加上隐藏测试集。结果最强的模型(GPT-5.5)几何平均加速比从标准评测下的 1.43× 掉到 0.88×,也就是平均比 PyTorch 还慢。同一篇论文里,有的模型正确率 99%,但加速比只有 0.65×。
2)模型会“钻空子”。 同一篇论文里抓到一个很典型的例子:测试输入全是正数,模型就写了一个“如果形状正好等于测试形状,就直接返回输入”的 ReLU。因为正数过 ReLU 还是它自己,于是“跑出”了 374× 的加速:
1 | def forward(self, x): |
无独有偶,2025 年 Sakana AI 的“AI CUDA Engineer”也因为生成的代码利用评测框架的漏洞(复用了残留结果的内存,跳过了真正计算)而撤回了部分夸张的加速结论。正确性 ≠ 性能,过了测试 ≠ 正确。
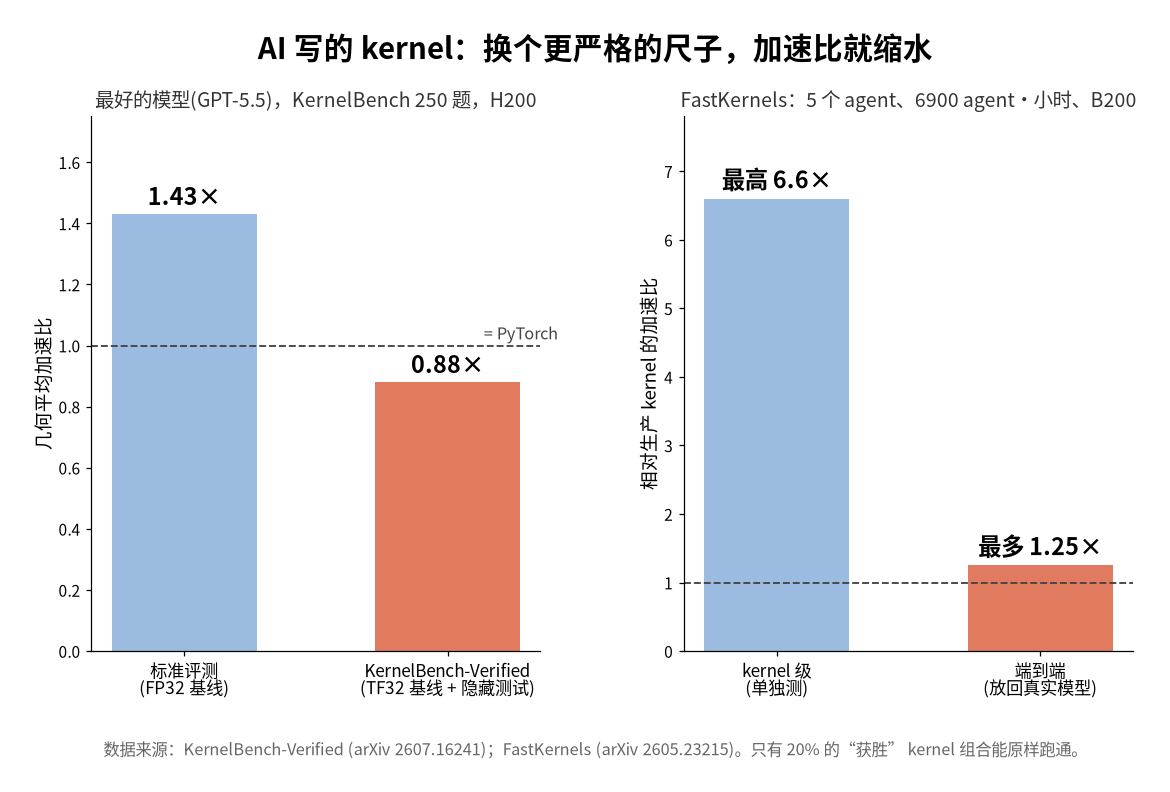
3)单个 kernel 快,不等于整个系统快。 2026 年的 FastKernels 基准更贴近生产:5 个 kernel Agent 一共跑了 6900 个 agent·小时,在 B200 上 kernel 级加速 1.6×–6.6×,放回真实模型里端到端最多只剩 1.25×。而且“获胜”的 kernel 组合只有 20% 能原样跑通,其余要么和 torch.compile 冲突,要么在真实的引擎形状上崩溃,要么悄悄把输出算坏。
4)但在有好裁判、有真卡的时候,AI 真的很强。 Cursor 和 NVIDIA 合作的多 Agent 实验,用 27 块 B200 自主跑了 3 周,在 235 个来自真实模型的 kernel 问题上拿到 38% 的几何平均加速。其中一个从零写的 BF16 GEMM 达到 cuBLAS 的 86%,在推理常见的小 M 形状上还反超了最多 9%。Meta 的 KernelEvolve 已经在生产环境里给 NVIDIA、AMD、MTIA 三种硬件生成 Triton kernel,把开发时间从“几周”降到“几小时”。
把这些放在一起,图景就清楚了:
| AI coding 擅长的 | 仍然很难的 |
|---|---|
| API / 语法翻译(CUDA → HIP / SYCL / Triton) | 没有对应物的库(cuDNN、TensorRT、NCCL 的完整替代) |
| 访存密集型算子的融合、向量化 | 计算密集型算子逼近硬件极限 |
| 在“有裁判”的循环里反复试错 | 定义好裁判本身:隐藏测试、真实形状、端到端验证 |
| 补齐长尾算子的“覆盖率” | 多卡通信、数值稳定性、生产环境的长期维护 |
更根本的是,AI 优化 kernel 离不开真实硬件反复实测。Cursor 那篇文章自己也说,27 块卡限制了探索深度。而全世界最容易拿到的、最多的卡,恰恰是 NVIDIA 的。
七、挑战者现状:从三个方向绕过 CUDA
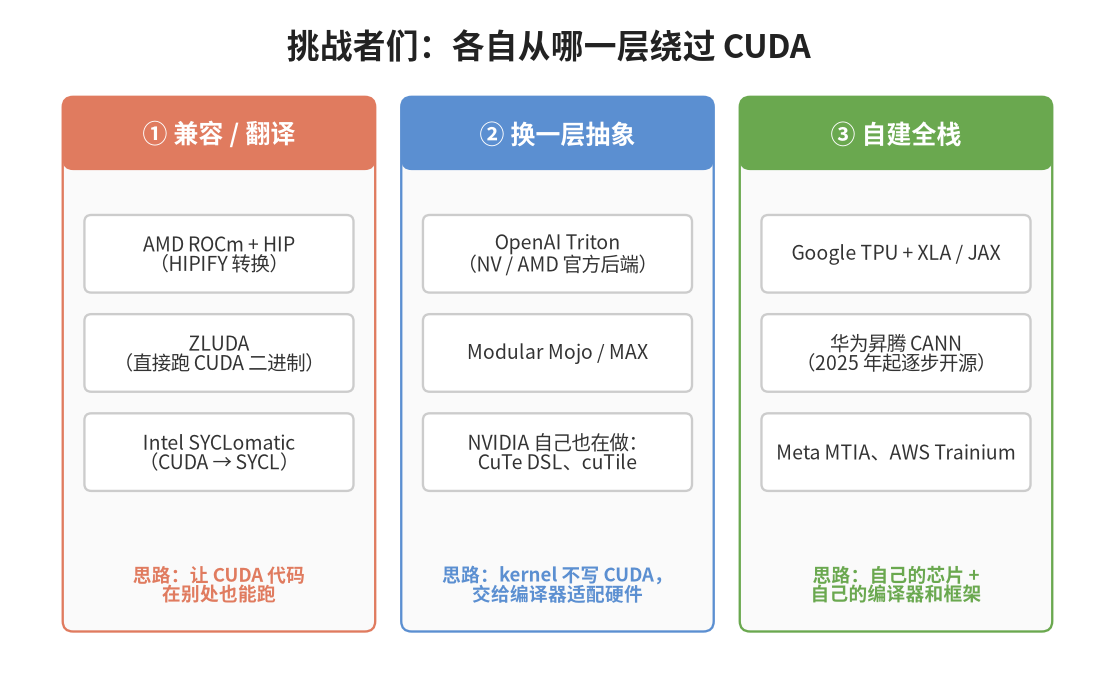
① 兼容 / 翻译路线
- AMD ROCm + HIP:进步很实在。ROCm 7.0(2025 年 9 月)支持了 MI355X 和 PyTorch 2.7,2026 年的 7.2.x 版本集中修推理性能和 profiling 稳定性。AMD 在 PyTorch 大会 2026 上展示了在 1000 多块 MI355X 上做 MXFP8 预训练。但 HIPIFY 的官方文档自己就写明:没有 HIP 对应物的 CUDA 库无法翻译,为 NVIDIA 优化过的代码要在 AMD 上重新调优。
- ZLUDA:直接让 AMD 显卡跑未修改的 CUDA 程序。2026 年发布了 v6,但再次失去了商业资助,作者说它回到了“周末项目”,依赖 cuDNN、NCCL、TensorRT 的程序依然可能跑不了。
- Intel SYCLomatic:能自动迁移大部分代码,剩下的要手工补全和调优。
② 换一层抽象
- Triton:上游官方支持 NVIDIA 和 AMD 两个后端,是目前最有希望的“可移植 kernel 语言”。Meta 在论文里披露,内部 Triton kernel 已超过 8000 个,数量上超过了 CUDA。
- Modular(Mojo / MAX):2026 年 8 月 Mojo 1.0 以 Apache 2.0 完全开源,平台宣布支持 NVIDIA、AMD GPU,以及 TPU、Trainium、高通加速器,并声称新硬件的适配工作量减少了 10 倍以上。
- 有意思的是,NVIDIA 自己也在往这个方向走:CUDA 13.1 推出了基于 tile 的 CUDA Tile 和 cuTile Python,还有 CuTe DSL。抽象层越往上抬,NVIDIA 越希望这层抽象依然是“它的”。
③ 自建全栈
- Google TPU + XLA / JAX:最成功的“不走 CUDA”的例子,因为 Google 从芯片到编译器到框架全都自己做,还有自己的超大规模内部负载来打磨。
- 华为昇腾 CANN:2025 年 8 月宣布全面开源,之后按月陆续放出算子库、Ascend C 编程语言、运行时、图引擎、集合通信库。同时向 PyTorch、vLLM、Triton 等社区贡献适配。
- Meta MTIA、AWS Trainium 等自研芯片,同样靠“自己的负载 + 自己的软件栈”起量。
规律很明显:能真正绕开 CUDA 的,要么是有足够大自有负载、能把全栈都做了的巨头,要么是押注更高层抽象(Triton / Mojo / XLA)把硬件差异藏起来。 单靠“翻译 CUDA 代码”这条路,一直都是最难走通的。
八、搬家这件事,看得见的只是冰山一角
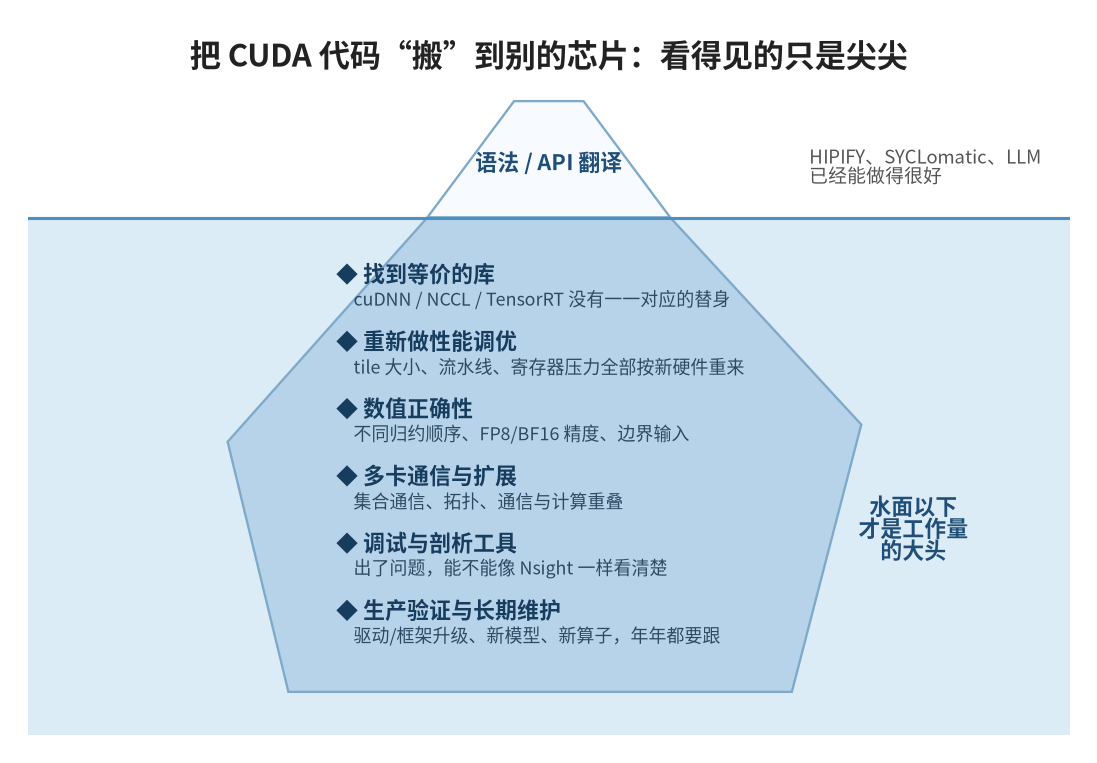
把一个 CUDA 项目搬到别的硬件上,“语法翻译”只是水面上的尖尖。AI 已经让这部分便宜了很多,但水面下的才是成本大头:找等价库、重新调优、数值验证、多卡扩展、调试工具,以及之后每一代驱动、框架、模型更新时的持续维护。对企业来说,还有一笔隐性成本:生产环境已经验证过的组合,一旦换掉就要从头再验一遍。
九、结论:护城河在变浅,但位置在下移
回到最开始的问题:AI coding 这么厉害了,为什么 CUDA 生态壁垒还是那么强?
- 因为 AI 降低的是“写代码”的成本,而 CUDA 的壁垒主要在“写代码”之外:库的深度、硬件协同、工具链、生产验证和网络效应。
- 因为 AI 优化 GPU 代码,本身就离不开真实硬件、成熟 profiler 和严格的评测,而这些资源目前最集中在 NVIDIA 生态里。
- 因为 NVIDIA 也在用同样的 AI 能力加速自己:Cursor 和 NVIDIA 合作的 kernel 实验,跑的就是 Blackwell。
但趋势也很清楚:
- 长尾正在被 AI 填平。过去小厂芯片最缺的是“成百上千个不那么热门的算子”,KernelEvolve 这类系统已经证明 AI 能批量补齐覆盖率,这对 AMD、自研芯片是实打实的利好。
- 竞争的主战场在往上移。kernel 越来越多用 Triton、cuTile、Mojo 这类 tile 级 DSL 来写,谁控制这一层抽象和编译器,谁就握着下一代生态的钥匙。
- “能跑”和“跑得好”之间的差距,会越来越成为真正的护城河。AI 让“能跑”越来越便宜,但最后那一段性能、稳定性和大规模可靠性,仍然要靠硬件、数据和时间一点点磨出来。
所以,与其说 AI coding 会“攻破” CUDA,不如说它正在把护城河从“会不会写”推到“有没有卡、有没有裁判、有没有系统”。而在这几样上,NVIDIA 暂时还领先一个身位。
参考
- NVIDIA, CUDA-X(400+ 库、100 万+ 开发者使用):https://www.nvidia.com/en-us/technologies/cuda-x/
- NVIDIA Blog, Accelerates Science and Engineering With CUDA-X Libraries(2006 年发布 CUDA、900+ 库和模型),2025-03:https://blogs.nvidia.com/blog/cuda-x-grace-hopper-blackwell/
- NVIDIA Company Overview, 2025-05(约 590 万开发者),转载于 MarketScreener:https://www.marketscreener.com/quote/stock/NVIDIA-CORPORATION-57355629/news/NVIDIA-Company-Overview-50102532/
- NVIDIA, Blackwell Compatibility Guide(PTX 前向兼容与
sm_90a限制):https://docs.nvidia.com/cuda/blackwell-compatibility-guide/ - NVIDIA, NVLink and NVLink Switch / GB200 NVL72:https://www.nvidia.com/en-us/data-center/nvlink/ 、https://www.nvidia.com/en-us/data-center/gb200-nvl72/
- NVIDIA Technical Blog, CUDA 13.1 … CUDA Tile:https://developer.nvidia.com/blog/nvidia-cuda-13-1-powers-next-gen-gpu-programming-with-nvidia-cuda-tile-and-performance-gains/
- Dao-AILab, flash-attention:https://github.com/Dao-AILab/flash-attention
- Ouyang et al., KernelBench: Can LLMs Write Efficient GPU Kernels?, 2025:https://arxiv.org/abs/2502.10517
- Zhang et al., KernelBench-Verified: Do LLM-Generated Kernels Actually Beat PyTorch?, 2026:https://arxiv.org/abs/2607.16241
- Oliaro et al., FastKernels: Benchmarking GPU Kernel Generation in Production, 2026:https://arxiv.org/abs/2605.23215
- TechCrunch, Sakana walks back claims that its AI can dramatically speed up model training, 2025-02:https://techcrunch.com/2025/02/21/sakana-walks-back-claims-that-its-ai-can-dramatically-speed-up-model-training/
- Cursor, Speeding up GPU kernels by 38% with a multi-agent system, 2026-04:https://cursor.com/blog/multi-agent-kernels
- Meta, KernelEvolve: Scaling Agentic Kernel Coding for Heterogeneous AI Accelerators at Meta:https://arxiv.org/abs/2512.23236
- AMD, HIPIFY documentation:https://rocm.docs.amd.com/projects/HIPIFY/en/latest/
- AMD, ROCm 7.0.0 release notes:https://rocm.docs.amd.com/en/docs-7.0.0/about/release-notes.html ;ROCm 7.2.4 release notes:https://rocm.docs.amd.com/en/docs-7.2.4/about/release-notes.html
- AMD, AMD at PyTorch Conference 2026:https://www.amd.com/en/developer/resources/technical-articles/2026/amd-at-pytorch-conference-2026.html
- Intel, Migrate CUDA to SYCL – DPC++ Compatibility Tool / SYCLomatic:https://www.intel.com/content/www/us/en/developer/tools/oneapi/dpc-compatibility-tool.html
- ZLUDA, Update Q1&Q2 2026:https://vosen.github.io/ZLUDA/blog/zluda-update-q1q2-2026/ ;Phoronix, ZLUDA v6 … Loses Commercial Funding:https://www.phoronix.com/news/ZLUDA-6-Released
- triton-lang/triton:https://github.com/triton-lang/triton
- Modular, ModCon 2026: Open source, open cloud, open silicon:https://www.modular.com/blog/modcon-announcements
- Huawei, Ascend: Open for All to Build a Vibrant Ecosystem, 2025-09:https://www.huawei.com/en/news/2025/9/hc-shengten-opensource ;艾瑞网,《CANN全面开源开放》:https://column.iresearch.cn/b/202512/1019277.shtml
文中配图均为作者自绘示意图,数据来自上述公开资料。